1 简介-RocketMQ ​
RocketMQ是一个消息中间件。
1.1 消息中间件是什么? ​
中间件:顾名思义 介于两者之间的一个技术

消息中间件:消息中间件利用高效可靠的消息传递机制进行平台无关的数据交流,并基于数据通信来进行分布式系统的集成。
1.2 RocketMQ是什么? ​
RocketMQ是阿里巴巴开源的一个消息中间件,是一个队列模型的消息中间件,具有高性能、高可靠、高实时、分布式特点。目前已贡献给apache
参考阅读链接:RocketMQ的前世今生
2 功能 ​
2.1 异步化 ​
将一些可以进行异步化的操作通过发送消息来进行异步化,提高效率
具体场景:用户为了使用某个应用,进行注册,系统需要发送注册邮件并验证短信。对这两个操作的处理方式有两种:串行及并行。
串行方式:新注册信息生成后,先发送注册邮件,再发送验证短信

在这种方式下,需要最终发送验证短信后再返回给客户端。
并行处理:新注册信息写入后,发短信和发邮件并行处理
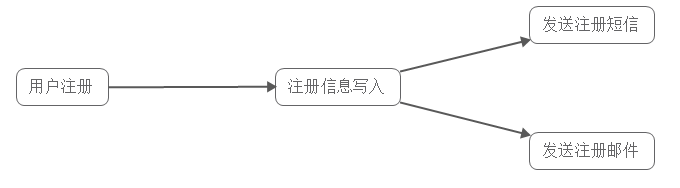
在这种方式下,发短信和发邮件 需处理完成后再返回给客户端。
假设以上三个子系统处理的时间均为50ms,且不考虑网络延迟,则总的处理时间:
串行:50 + 50 + 50 = 150ms 并行:50 + 50 = 100ms使用消息队列
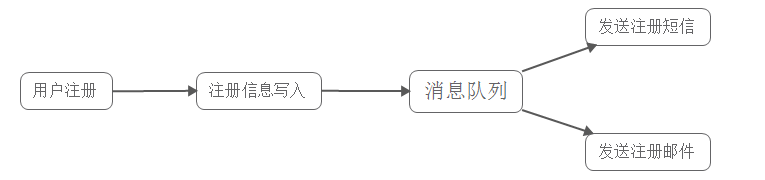
并在写入消息队列后立即返回成功给客户端,则总的响应时间依赖于写入消息队列的时间,而写入消息队列的时间本身是可以很快的,基本可以忽略不计,因此总的处理时间相比串行提高了2倍,相比并行提高了一倍;
什么样的操作可以异步化呢?
这一步操作的执行结果不会影响到主业务的执行结果,即主业务的处理结果不依赖于这个可以异步化的操作的执行结果
2.2 限流削峰 ​
在高并发场景下把请求存入消息队列,利用排队思想降低系统瞬间峰值
具体场景:购物网站开展秒杀活动,一般由于瞬时访问量过大,服务器接收过大,会导致流量暴增,相关系统无法处理请求甚至崩溃。而加入消息队列后,系统可以从消息队列中取数据,相当于消息队列做了一次缓冲。

优点:
- 请求先入消息队列,而不是由业务处理系统直接处理,做了一次缓冲,极大地减少了业务处理系统的压力;
- 事实上,秒杀时,后入队列的用户无法秒杀到商品,这些请求可以直接被抛弃,返回活动已结束或商品已售完信息;
2.3 对比 ​
消息中间件不仅仅只有RocketMQ,市面上还有很多其他的消息中间件,这里列举几个常见的和RocketMQ作为一个对比
ActiveMQ:ActiveMQ 是Apache出品,最流行的,能力强劲的开源消息总线。ActiveMQ 是一个完全支持JMS1.1和J2EE 1.4规范的 JMS Provider实现,是使用Java语言编写的。
JMS: 全称是Java Message Service,即消息服务应用程序接口,是一个Java面向消息中间件平台的API,用于在两个应用程序之间,或分布式系统中发送消息,进行异步通信RabbitMQ:AMQP协议的领导实现,支持多种场景。淘宝的MySQL集群内部有使用它进行通讯,OpenStack开源云平台的通信组件,最先在金融行业得到运用,使用Erlang语言编写的。
AMQP: 即Advanced Message Queuing Protocol,一个提供统一消息服务的应用层标准高级消息队列协议,是应用层协议的一个开放标准,为面向消息的中间件设计Kafka: Kafka是最初由Linkedin公司开发,是一个分布式、支持分区的(partition)、多副本的(replica),基于zookeeper协调的分布式消息系统,它的最大的特性就是可以实时的处理大量数据以满足各种需求场景:比如基于hadoop的批处理系统、低延迟的实时系统、storm/Spark流式处理引擎,web/nginx日志、访问日志,消息服务等等,用scala语言编写,Linkedin于2010年贡献给了Apache基金会并成为顶级开源 项目。
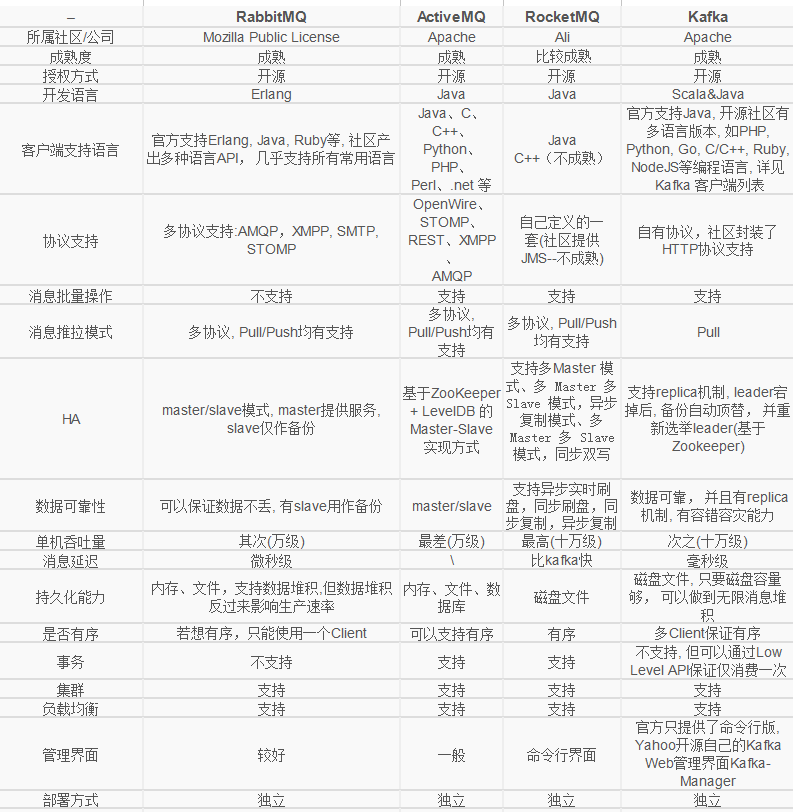
# 各个消息队列的优缺点:

    1. ActiveMQ
    缺点:已经过时了,社区不是很活跃,性能不好(消息堆积能力一般, 消息的延迟比较高, 并发能力不是很强(单机吞吐量低))
    2. RabbitMQ
    优点:功能比较完善,在金融领域应用很广, 消息延迟时间非常低,使用起来也比较灵活
    缺点:使用Erlang语言编写,源码不太好懂,出了问题只能去官方社区求助,不能自己看源码定位问题,解决问题

    3. Kafka
    优点: 单机吞吐量非常大,消息堆积能力强,在大数据领域应用广泛
    缺点: 功能不是特别多,消息延迟不及RabbitMQ

    4. RocketMQ
    优点:功能比较完善,和RabbitMQ差不多,而消息的堆积能力和并发能力又不比Kafka差;并且使用Java语言编写,对Java程序员比较友好。
    缺点:消息的延迟是不及RabbitMQ的,主要是因为是Java语言开发的,语言的效率一般
3 模型(RocketMQ) ​
3.1 概念模型 ​
Producer: 消息生产者,负责消息的产生,由业务系统负责产生
Consumer:消息消费者,负责消息消费,由后台业务系统负责异步消费
Topic:消息的逻辑管理单位(消息的一个属性,并且每个消息都一定有这个属性)
这三者是RocketMq中最最基本的概念。Producer是消息的生产者。Consumer是消息的消费者。消息通过Topic进行传递。Topic存放的是消息的逻辑地址。
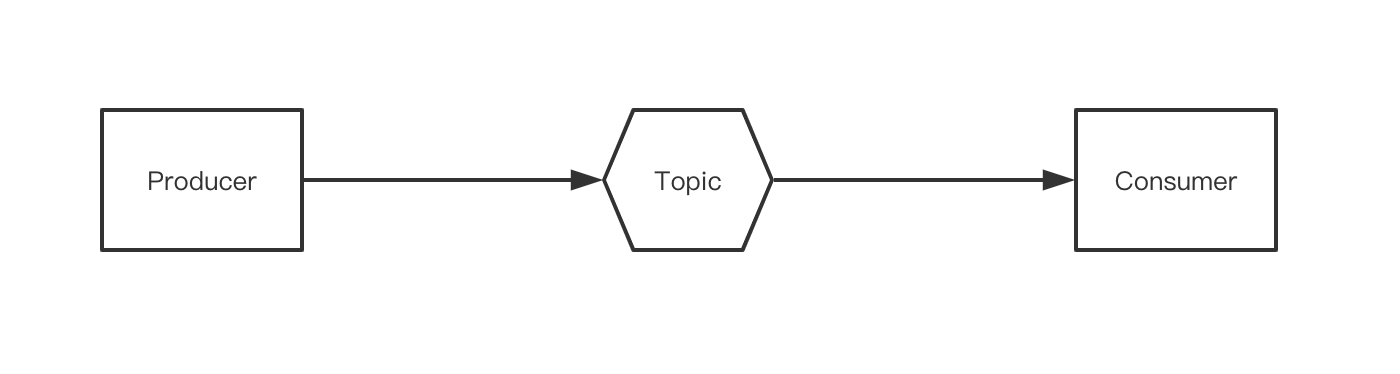
具体来说是Producer将消息发往具体的Topic。Consumer订阅Topic,主动拉取或被动接受消息,如果Consumer消费消息失败则默认会重试16次
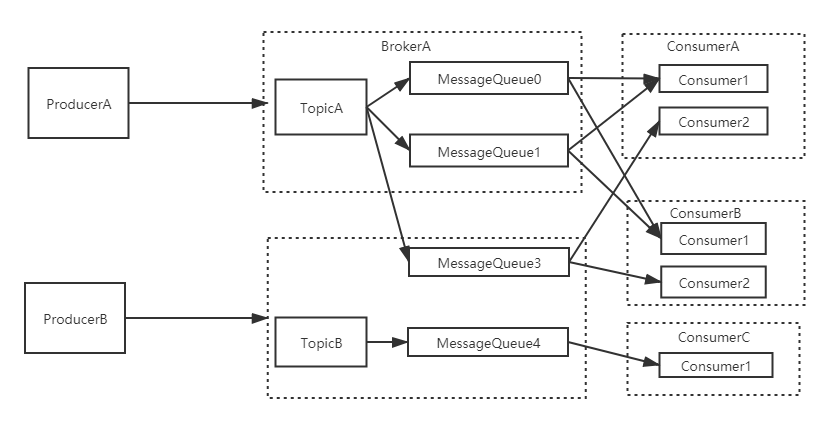
Broker: 消息的中转角色,负责存储消息,转发消息,一般也称为server,可以理解为一个存放消息的服务,里面可以有多个Topic
MessageQueue: 消息的物理管理单位,一个Topic下有多个Queue,默认一个Topic创建时会创建四个MessageQueue
ConsumerGroup: 接收同一个topic类型的消息,并且具有同样消费逻辑消费同样消息的Consumer,可以归并为一个group
ProducerGroup: 具有同样属性的一些Producer可以归并为同一个Group
同样属性是指:发送同样Topic类型的消息
Nameserver 注册中心
作用:
- 每个Broker启动的时候会向namesrv注册
- Producer发送消息的时候根据Topic获取路由到Broker里面Broker的信息
- Consumer根据Topic到Namesrv 获取topic的路由到Broker的信息
3.2 部署模型 ​
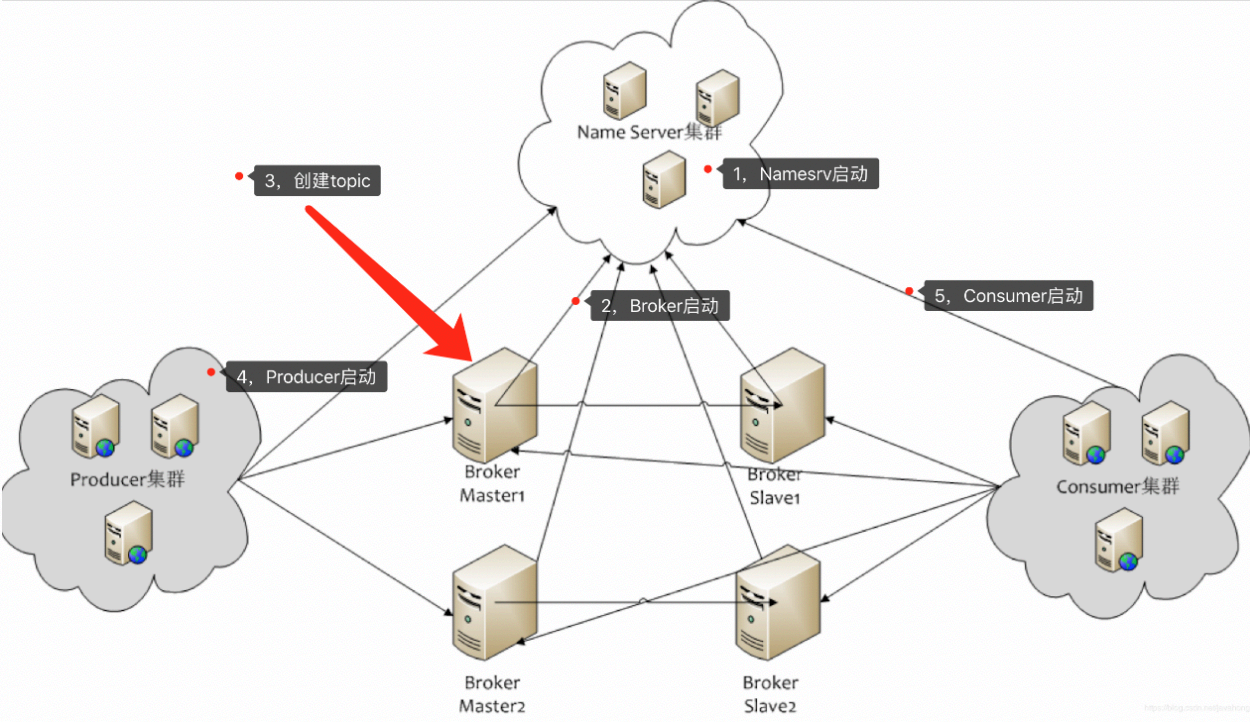
注册中心Nameserver启动
消息中转服务Broker启动
启动的时候会去创建Topic并创建对应的MessageQueue
启动的时候会去注册中心注册,把自己的地址以及负责的Topic告诉注册中心
Broker和Nameserver之间通过心跳机制来检测对方是否存活
xml连接: 单个broker和所有nameserver保持长连接 心跳: 心跳间隔:每隔30秒(此时间无法更改)向所有nameserver发送心跳,心跳包含了自身的topic配置信息。 心跳超时:nameserver每隔10秒钟(此时间无法更改),扫描所有还存活的broker连接,若某个连接2分钟内(当前时间与最后更新时间差值超过2分钟,此时间无法更改)没有发送心跳数据,则断开连接。
消息生产者Produer启动
启动时:
- 单个生产者者和一台nameserver保持长连接,定时查询topic配置信息
- 单个生产者和该生产者关联的所有broker保持长连接。
运行时:
- 默认情况下,生产者每隔30秒从nameserver获取所有topic的最新队列情况
- 发送消息时,根据从nameserver获取的路由信息,根据发送消息的Topic和目标Broker建立连接
- 默认情况下,生产者每隔30秒向所有broker发送心跳,该时间由DefaultMQProducer的heartbeatBrokerInterval参数决定,可手动配置。broker每隔10秒钟(此时间无法更改),扫描所有还存活的连接,若某个连接2分钟内(当前时间与最后更新时间差值超过2分钟,此时间无法更改)没有发送心跳数据,则关闭连接
消息消费者Consumer启动
启动时:
- 单个消费者和一台nameserver保持长连接,定时查询topic配置信息
- 单个消费者和该消费者关联的所有broker保持长连接。
运行时:
- 默认情况下,消费者每隔30秒从nameserver获取所有topic的最新队列情况
- 默认情况下,消费者每隔30秒向所有broker发送心跳,该时间由DefaultMQPushConsumer的heartbeatBrokerInterval参数决定,可手动配置。broker每隔10秒钟(此时间无法更改),扫描所有还存活的连接,若某个连接2分钟内(当前时间与最后更新时间差值超过2分钟,此时间无法更改)没有发送心跳数据,则关闭连接
3.4 注意事项 ​
同步刷盘与异步刷盘:
RocketMQ的消息是存储到磁盘上的,这样既能保证断电后恢复,又可以让存储的消息量超出内存的限制。
RocketMQ为了提高性能,会尽可能地保证磁盘的顺序写。消息在通过Producer写入RocketMQ的时候,有两种写磁盘方式:
异步刷盘:在返回写成功状态时,消息可能只是被写入了内存中,写操作的返回快,
吞吐量大;当内存里的消息量积累到一定程度时,统一触发写磁盘操作,快速写入
同步刷盘:在返回写成功状态时,消息已经被写入磁盘。具体流程是,消息写入内存后,立刻通知刷盘线程刷盘,然后等待刷盘完成,刷盘线程执行完成后唤醒等待的线程,返回消息写成功的状态。
同步刷盘还是异步刷盘,是通过Broker配置文件里的flushDiskType参数设置的,这个参数被设置成SYNC_FLUSH、ASYNC_FLUSH中的一个
同步复制与异步复制
如果一个broker组有Master和Slave,消息需要从Master复制到Slave上,有同步和异步两种复制方式。
同步复制是等Master和Slave均写成功后才反馈给客户端写成功状态;异步复制方式是只要Master写成功即可反馈给客户端写成功状态
同步复制和异步复制是通过Broker配置文件里的brokerRole参数进行设置的,这个参数可以被设置成
ASYNC_MASTER、SYNC_MASTER、SLAVE三个值中的一个。
4 安装使用 ​
4.1 安装 ​
参考 [环境搭建.md](..\08_ 环境搭建\环境搭建.md)
4.4 配置文件 ​
我们在windows下安装RocketMQ,消息数据默认会被存储在c盘,如果有同学c盘已经满了,那么此时我们可以修改数据的存储路径到任意位置,通过在配置文件中添加如下配置即可:这里稍微注意下,如果是windows的路径,那么目录与目录之间用/而不是\分割,比如d:/store/...
# 所属集群名称,如果节点较多可以配置多个
brokerClusterName = DefaultCluster
#broker名称,master和slave使用相同的名称,表明他们的主从关系
brokerName = broker-a
#0表示Master,大于0表示不同的slave
brokerId = 0
#表示几点做消息删除动作,默认是凌晨4点
deleteWhen = 04
#在磁盘上保留消息的时长,单位是小时
fileReservedTime = 48
#有三个值:SYNC_MASTER,ASYNC_MASTER,SLAVE;同步和异步表示Master和Slave之间同步数据的机制;
brokerRole = ASYNC_MASTER
#刷盘策略,取值为:ASYNC_FLUSH,SYNC_FLUSH表示同步刷盘和异步刷盘;SYNC_FLUSH消息写入磁盘后才返回成功状态,ASYNC_FLUSH不需要;
flushDiskType = ASYNC_FLUSH
# 设置broker节点所在服务器的ip地址
brokerIP1 = 192.168.233.129
# 磁盘使用达到95%之后,生产者再写入消息会报错 CODE: 14 DESC: service not available now, maybe disk full
diskMaxUsedSpaceRatio=95
5 整合 ​
5.1 导包 ​
<dependency>
	<groupId>org.apache.rocketmq</groupId>
	<artifactId>rocketmq-client</artifactId>
	<version>4.4.0</version>
</dependency>
5.2 普通消息 ​
- 消息生产者
public static void main(String[] args){
  	// 新增消息生产者
  	DefaultMQProucer producer = new DefaultMQProucer("producer_group");
  	// 配置注册中心
  	producer.setNamesrvAddr("localhost:9876");
  	// 启动
  	producer.start();
  	// 新建消息对象
  	Message message = new Message("topicA","message".context.getBytes(Charset.forName("utf-8")));
  	// 发送消息
  	producer.send(message);
}- 消息消费者
public static void main(String[] args) throws MQClientException {
        DefaultMQPushConsumer mqConsumer = new DefaultMQPushConsumer("consumer_group");
        mqConsumer.setNamesrvAddr("localhost:9876");
        mqConsumer.subscribe("topicA", "*");
				// 设置消息监听器
        mqConsumer.registerMessageListener(new MessageListenerConcurrently() {
            @Override
            public ConsumeConcurrentlyStatus consumeMessage(List<MessageExt> msgs, ConsumeConcurrentlyContext context) {
                MessageExt message = msgs.get(0);
              //获取消息内容
                byte[] body = message.getBody();

        });

        mqConsumer.start();
5.3 延迟消息 ​
- 消息生产者
    public static void main(String[] args) throws MQClientException, UnsupportedEncodingException, RemotingException, InterruptedException, MQBrokerException {
    // 1. 创建Producer对象
        DefaultMQProducer produce = new DefaultMQProducer("delay_producer_group");
        producer.setNamesrvAddr("127.0.0.1:9876");
        producer.start();

        // 准备消息
        Message message = new Message();
        message.setTopic("test_delay");
        message.setBody("hello,delay".getBytes("utf-8"));
        // 非常简单  延迟级别
        //  1s   5s  10s 30s 1m 2m 3m 4m 5m 6m 7m 8m 9m 10m 20m 30m 1h 2h
        //  1    2    3  4   5  6  7  8  9 10  11 12 13 14 15  16   17 18
        message.setDelayTimeLevel(2);
        // 发送
        SendResult send = producer.send(message);
        System.out.println(send);
}- 消息消费者(和普通的消息消费者没有区别)
当然,我们也可以修改延迟消息的延迟级别所对应的具体时间,只需要在broker配置文件里增加如下配置即可
messageDelayLevel=1s 5s 10s 30s 1m 2m 3m 4m 5m 6m 7m 8m 9m 10m 20m 30m 1h 2h 15s笔记 ​
- rocketMQ是复合JMS标准的一种实现,JMS对标JDBC
- 消息被消费完可以删除吗?不删除,可能别的消费组还要用。被所有消费组消费完之后,会用定时任务清除凌晨四点
- 订单自动取消也可以用Spring的定时任务注解@Scheduled
- 低延迟用RabbitMQ金融,大数据用Kafka
- 消费完的消息要不要删除:每个消费者组都有消费位点
- 磁盘顺序写要快很多
- 如果消息重复16次失败,那存储到磁盘死信