包装 ​
- 项目上线了吗?上线了,但我没有生产环境的账号,平时在开发用的是开发环境或者测试环境的账号
- 一年的项目少说做10个模块
自我介绍 ​
- 个人背景
- 掌握的技术栈
- 求职意向
技术面 ​
TCP/IP协议 ​
七层模型
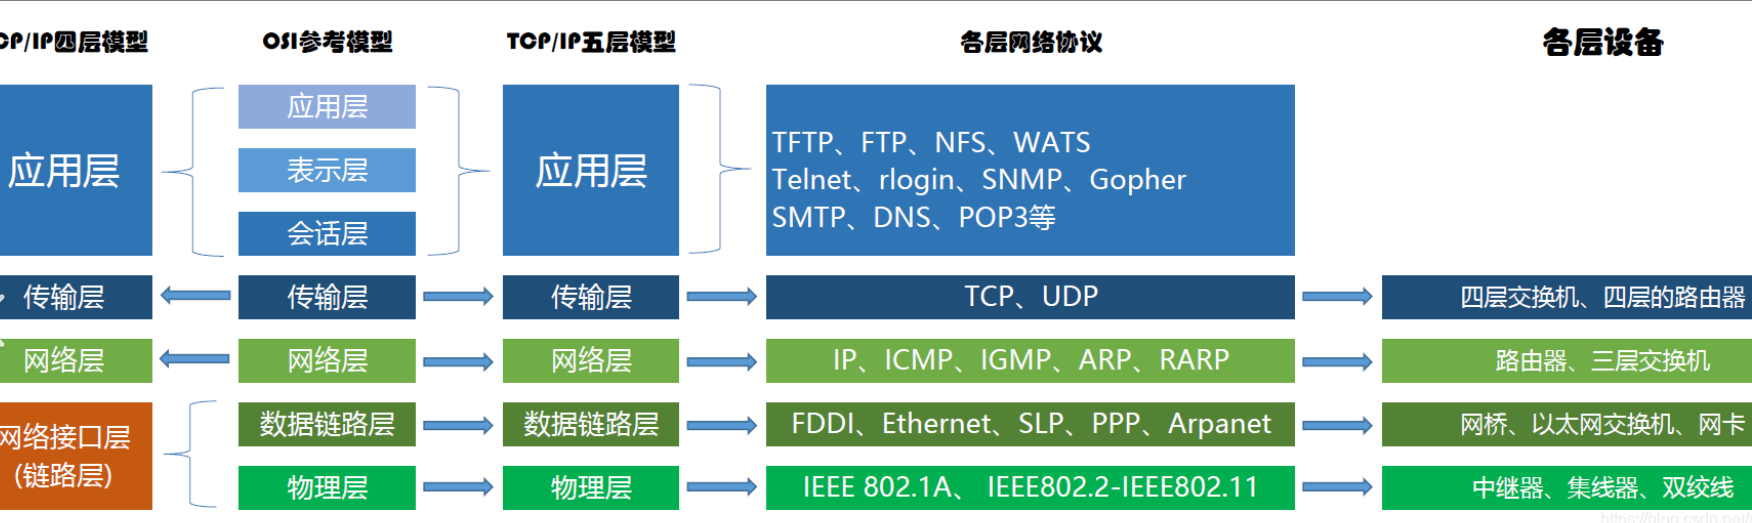
TCP为什么三次握手四次挥手,
TCP为什么会粘包:TCP是面向buffer的,buffer大小是有限制的,才会导致
多一次少一次行不行:
- 需要三次握手才能确认彼此是能发能收的状态不然会有一些无效连接的产生
拥塞控制算法
SE ​
final关键字
用来说明最终属性
表明一个类不能派生出子类
或者成员方法不能被覆盖
或者成员域的值不能被改变,用来定义常量
操作String的常用函数
常见的异常类型,异常和错误有什么区别:
- 错误是程序无法处理的,典型的OOM,JVM会选择终止线程
- 异常是程序可以处理的。分为编译期异常和运行期异常
接口和抽象类区别
- 接口多实现,抽象类单继承
- 思想:接口like a标准或行为的抽象,抽象类is a属性模板的抽象
JVM ​
类加载机制
什么是类加载:一个类从被加载到JVM内存中开始,到卸载出内存为止,一个类的生命周期
类加载的时机
创建类的实例(首次创建该类对象)
访问类的静态变量(首次) 调用类的静态方法(首次)
加载某个类的子类,会先触发父类的加载
直接使用java.exe命令来运行某个主类,也就是执行了某个类的main()方法
使用反射方式来强制创建某个类或接口对应的java.lang.Class对象
类加载的步骤

一共是:
加载(Loading)
验证(Verification)
准备(Preparation)
解析(Resolution)
初始化(Initialization)
使用(Using)
卸载(Unloading)
注:其中,验证、准备和解析可以统称为。
一个类在JVM中的生命周期,共有七个阶段。
其中"加载 --> 连接 ---> 初始化"这三个步骤,即一个类的类加载过程。
这三步主要做:
- 主要是做通过类加载器ClassLoader,将class字节码文件读取进JVM内存的操作。并在内存中生存这个类对应的Class对象
在过程中:
验证,主要目的是为了确保class文件的字节流中包含的信息符合当前JVM的要求,不会影响JVM的安全。
准备,主要目的是进行静态成员变量的默认初始化,设置初始值。
这样,就保证了静态成员变量的默认初始化,永远最先进行。
解析,主要目的是将符号引用替换为直接引用。(不理解算了,目前不需要详细了解)
- 是类加载的最后一个步骤。主要目的是执行和static相关的内容,包括:
执行静态成员变量的显式赋值。
执行静态代码块。
以上,关于类加载各步骤,大致的作用,我们就了解了。
所以这里要重新认识一个概念:
类加载的时机,说得更准确一点,应该是。当然,想要初始化一个类,必然要先进行加载和连接。
双亲委派,类加载器的分类
Bootstrap ClassLoader 根类加载器 负责Java运行时核心类的加载,JDK中JRE的lib目录下rt.jar
Extension ClassLoader 扩展类加载器 负责JRE的扩展目录中jar包的加载,在JDK中JRE的lib目录下ext目录
Sysetm(App) ClassLoader 系统类加载器/应用加载器 负责加载自己定义的Java类
MyBatis ​
- 熟练掌握Mybatis框架,熟悉Mybatis对ORM的优化,熟练使用Mybatis-Plus的增强功能。
集合 ​
HashMap ​
化无限为有限,这就是哈希映射。将任意长度的输入通过散列算法变换成固定长度的输出。
好的hash算法希望对于不同的输入,得到不同的输出结果。
HashMap/LinkedHashMap/TreeMap ​
是否有序
H无序,L有序,T按照key的大小排序
是否允许重复的Key - 都不允许重复
是否允许存储Null - 只有T不允许key为null
API ​
如果删除一个不存在的key不会报错,只是remove的返回值oldValue为null
Redis ​
如 zset 可实现"排行榜",hash 可存储商城中的购物车信息以及用户信息等。
熟悉常见数据库如MySQL表、数据的操作、MySQL的查询索引和聚合函数, 多表的内外连接设计;熟悉 Redis几种常见数据结构如:String类型利用incr命令统计网站访问量、List双向队列做最新动态榜或原子性解决库存超卖、Set 进行查询共同好友或者好友推介,SortedSet(zset)实现分数段排名;
并发 ​
进程线程的区别。多线程run和start的区别
线程的几种状态
怎么理解线程安全问题:原子性、可见性
- java
public class pool1 {
    // public ThreadPoolExecutor(int corePoolSize,
    //                           int maximumPoolSize,
    //                           long keepAliveTime,
    //                           TimeUnit unit,
    //                           BlockingQueue<Runnable> workQueue,//new LinkedBlockingDeque<>()或ArrayBlock
    //                           ThreadFactory threadFactory,   //线程工厂
    //                           RejectedExecutionHandler handler)
    //IO密集型任务 corePoolSize:2 * CPU 核心数
     //计算密集型任务 corePoolSize: CPU 核心数 + 1
    public static void main(String[] args) {
        ExecutorService pool = new ThreadPoolExecutor(3, 5, 8, TimeUnit.SECONDS,
                new ArrayBlockingQueue<>(4), Executors.defaultThreadFactory(),
                new ThreadPoolExecutor.AbortPolicy());
    }
}
Spring ​
- @Controller是线程安全的吗
- 我们一个页面上面的一个 POS 请求嘛?对不对?那个它的整个到后台,到control,整个到数据库查询,是吧?嗯,就整个那个过程指标。
- 我们在 control 层应该怎么定义它?要用JSON 的方式。
- Spring是怎么读取配置文件的
SpringMVC ​
是什么
SpringMVC是Spring提供的一个强大而灵活的web框架,借助于注解,Spring MVC提供了几乎是POJO的开发模式【POJO是指简单Java对象(Plain Old Java Objects、pure old java object 或者 plain ordinary java object)。POJO的内在含义是指那些没有从任何类继承、也没有实现任何接口,更没有被其它框架侵入的Java对象。POJO让开发者可专注于业务逻辑和脱离框架的单元测试。可以把POJO看作是一个普通的Java类,它具有简单、灵活和可扩展的编程模型,使开发人员可以专注于业务逻辑的实现,而不需要过多考虑框架相关的规范和限制】,使得控制器的开发和测试更加简单。它是一个基于Java的实现MVC设计模型的请求驱动类型的轻量级Web框架,属于SpringFramework的后续产品,已经融合在Spring Web Flow中 ,你可以把SpringMVC看作是一个控制器,它负责处理用户请求并返回响应。在SpringMVC中,控制器(Controller)、视图(View)和模型(Model)是分离的。控制器负责处理用户请求并返回响应,视图负责显示数据,模型负责存储数据
为什么要用
1.清晰的角色划分:SpringMVC将控制器(controller)、验证器(validator)、命令对象(command object)、表单对象(form object)、模型对象(model object)、Servlet分发器(DispatcherServlet)、处理器映射(handler mapping)、试图解析器(view resolver)等等。每一个角色都可以由一个或多个组件来实现,这样的设计使得开发人员可以更加专注于业务逻辑的实现
2.无需配置:SpringMVC是一个典型的轻量级MVC框架,相对于之前的struts2框架,SpringMVC运行更快,其注解式开发更高效灵活。可以和Spring框架无缝整合
3.代码可重用性高:SpringMVC支持RESTful风格的URL设计和参数传递,这使得代码具有很好的可读性和可维护性
4.易于测试:SpringMVC支持JUnit和Mockito等测试框架,这使得开发人员可以更加方便地进行单元测
核心流程
参数封装
- get请求,参数在请求行URL中用@PathVariable
java@GetMapping("/admin/product/getAttrValueList/{attrId}") public Result<List<PlatformAttributeValueDTO>> getAttrInfoDTO(@PathVariable Long attrId) { List<PlatformAttributeValueDTO> data=platformAttributeService.getPlatformAttrInfo(attrId); return Result.ok(data); }get请求,在请求行的键值对中:http://localhost:8083/admin/auth/info?token=95d2603f
java@RequestMapping("admin/auth/info") public BaseRespVo info(@RequestParam("token")String token) { return BaseRespVo.ok(); }post请求,json字符串用@RequestBody
java@PostMapping("/admin/product/saveAttrInfo") public Result saveAttrInfo(@RequestBody PlatformAttributeParam platformAttributeParam) { platformAttributeService.savePlatformAttrInfo(platformAttributeParam); return Result.ok(); }@ConfigurationProperties是参数类配置文件和容器之间的桥梁
Linux ​
- docker容器化部署,怎么引用外部存储卷 -v,是什么机制
- 两个容器之间的 网络通信:一般都是用容器名 -link
- linux管道,dump MySQL怎么直接传输到另外一个服务器上。从内存直接传输到网络IO
分布式 ​
- 分布式事务
- 理论:CAP ,一致性、可用性、分区容忍性
项目 ​
项目三小程序教务系统 ​
- OSS和SMS:怎样整合第三方API,注册参数类组件,直接从配置文件里读取 Day21-demo3
- 为什么使用OSS对象存储?因为更快。自己的服务器上带宽有限
项目二论坛系统 ​
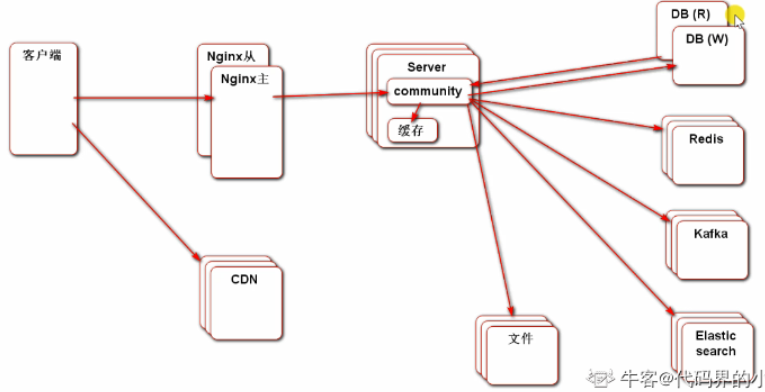
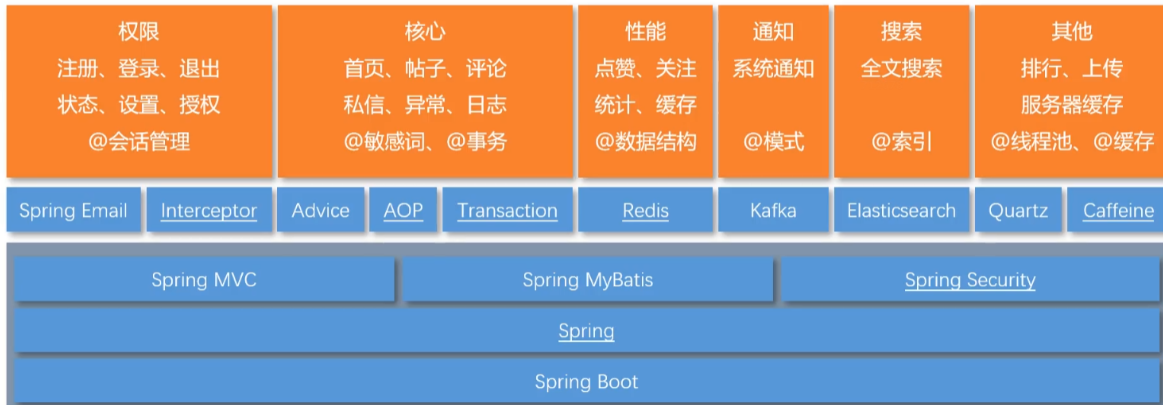
架构图 ​
SpringSecurity ​
请求转发与重定向区别
- 302重定向可以降低耦合,适用于两个不相关的。浏览器自动发起重定向请求,浏览器知道
- 请求转发可以共享一些数据。整个过程是一个请求,通过request共享数据。浏览器不知道自己访问了两个地址
登录Demo ​
跨域问题解决
设置代理
浏览器 在同一个页面访问不同的域 是存在跨域问题的
但 服务器之间的访问是 没有跨域问题
因此 需要在前端设置代理, 通过代理访问 SpringBoot后端API
前端设置
后端设置
- controller类上加注解@CrossOrigin
- filter里设置
JWT认证
shiro做认证和授权
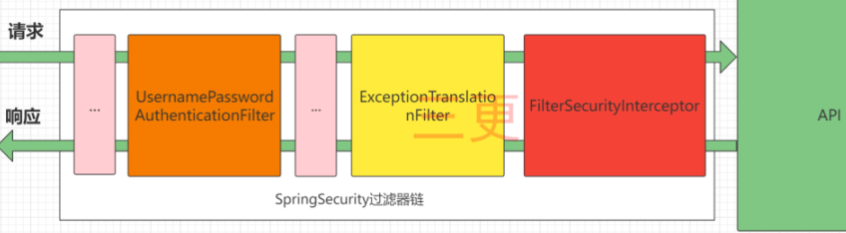
spring security做认证和授权
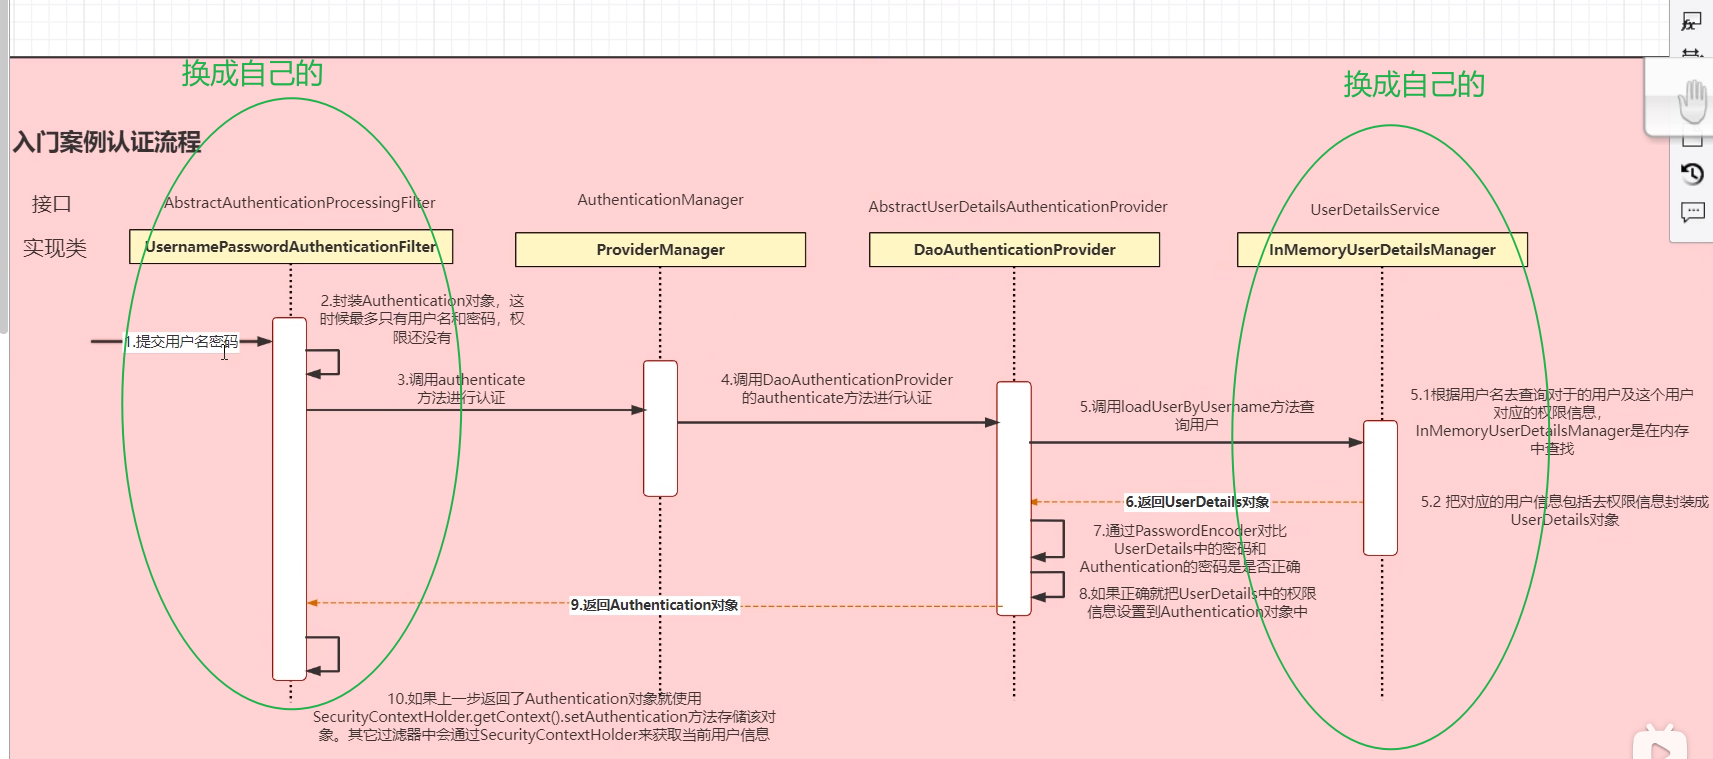
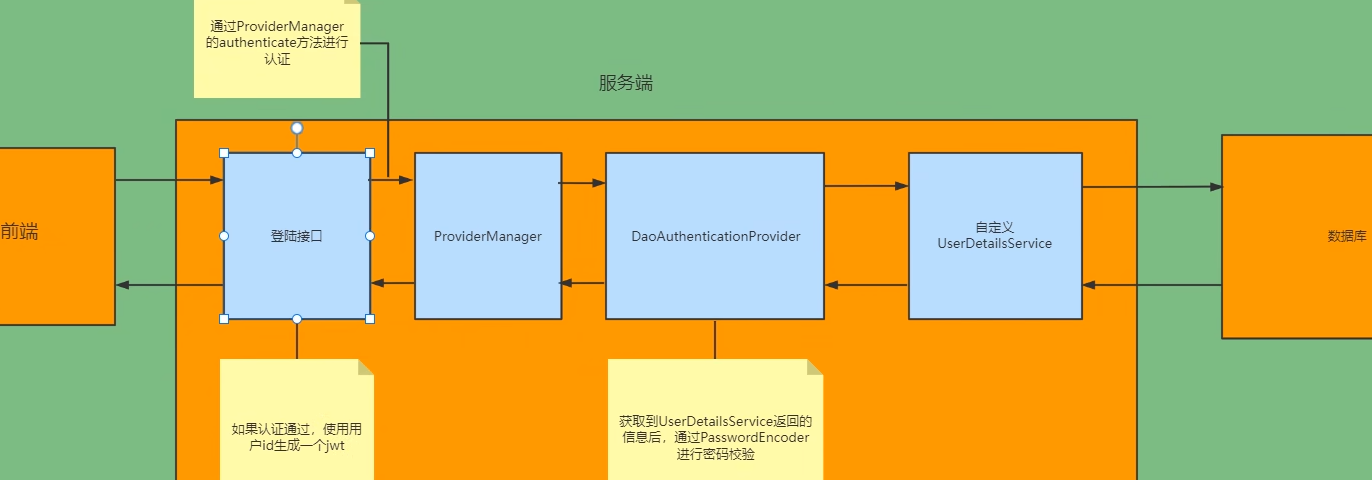
思路
【登录-未实现】
①、自定义登录接口。用于调用ProviderManager的方法进行认证 如果认证通过生成jwt,然后把用户信息存入redis中
②、自定义UserDetailsService接口的实现类。在这个实现类中去查询数据库
【校验-未实现】
①、定义Jwt认证过滤器。用于获取token,然后解析token获取其中的userid,还需要从redis中获取用户信息,然后存入SecurityContextHolder
【授权设置】
- 基于配置,一般用来这只静态资源的权限
- 基于注解,后端比较常用
问题
为什么要有redis参与: 是为了防止过了很久之后,浏览器没有关闭,拿着token也能访问,这样不安全
认证过滤器的作用是什么: 上面我们实现登录接口的时,当某个用户登录之后,该用户就会有一个token值,我们可以通过认证过滤器,由于有token值,并且token值认证通过,也就是证明是这个用户的token值,那么该用户访问我们的业务接口时,就不会被Security拦截。简单理解作用就是登录过的用户可以访问我们的业务接口,拿到对应的资源
spring security做登出的时候,用不用删掉SecurityContextHolder中的认证信息:不用。当用户调用登出功能时,Spring Security会执行一系列操作,其中包括清除认证信息、使会话无效等。因此,你通常不需要额外的操作来处理
SecurityContextHolder中的认证信息。
Kafka ​
引入依赖 - spring-kafka
配置Kafka - 配置server、consumer
访问Kafka
生产者
javakafkaTemplate.send(topic, data);消费者
java@KafkaListener(topics = {"test"}) public void handleMessage(ConsumerRecord record) {record.value()}
Canal ​
- canal开启MySQL主从复制的BinLog,并选用ROW模式。保证数据一致性,但需要存储空间大。Statement语句模式是相对的,虽然节省了空间,但可能数据不一致
- canal将自己伪装成MySQL从库slave,向master发送dump协议,master会把binLog推送给canal
项目名称:平安银行托管网银系统(重构) ​
技术栈: SpringBoot 2.x + SpringCloud Alibaba(Nacos/Consul服务发现) + MybatisPlus + Redis(分布式缓存/分布式锁) + RabbitMQ(异步解耦/削峰填谷) + Consul(配置中心) + 多数据源动态路由 项目描述: 平安银行托管业务核心系统重构项目,服务于银行对公客户资产托管场景,日均处理指令量10万+,涉及资金规模超千亿。系统模块包括: 指令中心:多角色协同的指令生成、串行化审批流引擎(支持动态审批链配置) 交易模块:转账业务(同行/跨行)、定期存款(智能转存/利息计算)、债券交易(全生命周期管理) 清结算对接:上清所/中债登报文自动化收发(ISO20022标准报文解析) 实时监控看板:基于Redis+ELK的指令状态追踪与业务指标统计 您的贡献: • 架构设计:主导MySQL分库分表方案设计(按业务模块垂直拆分),优化高频查询接口响应时间从800ms降至200ms。 • 核心开发: 实现基于RBAC+工作流的审批引擎(Activiti),支持7类指令的串行化审批,日均处理量提升300%。 债券模块性能优化:通过Redis缓存债券估值数据+MybatisPlus多级缓存,QPS从500提升至2000+。 • 稳定性保障:设计RabbitMQ死信队列+补偿机制,解决分布式场景下指令状态一致性问题,系统可用性达99.99%。
数据管控平台 ​
数据质量,数据标准,元数据,System服务,gateWay服务,调度中心
4797个分行机构,每天调度600个规则,每天单表100w
ruleProblem, problemDept, problem_dept_month,process,process_detail,rule_role,exam
数据量大/读写分离/分表/数据迁移容灾备份/拉链表/多线程线程池
元数据:数据源管理/数据采集
数据标准:发布标准,版本管理。数据标准管理建立规范的数据应用标准,消除数据的不一致性
数据质量:发现问题,发起整改。
规则管理,任务组管理,规则角色,规则调度,问题管理(问题导入,纳入跟踪,反馈,审批),统计报表(),规则导入,迁移调度
技术栈
- springSecurity + mapstruct + 达梦 + pgsql + springCloud + rocketMQ + ElesticSearch + Redis + MyBatisPlus + xxl-job
- 对于项目中设计模式的使用,有一下两个地方。1.使用工厂模式将各个类型的规则抽象封装,好处是什么我也不知道。2.使用模板方法模式,将四个模块中逻辑相同导出excel的代码
- executebatch迁移10w数据19s
- 导出48w行数据20s
- 笛卡尔积,联合索引
- 分布式锁有加过期时间吗
- 零拷贝
面试问答 ​
- Bug率低于5%或3%的时候就可以发版
- 碰到不会的,怎么体面回答?首先不要慌,理直气壮,不会是正常的。根据面试官的引导回答,如果还是不会,反客为主,问面试官。从技术交流的角度学习
- 微服务商城项目的性能瓶颈:
- 网关会成为瓶颈。nginx是流量网关,并发能力超强。可以用nginx代理网关
- 数据访问会成为瓶颈,读多写少,redis缓存优化
- 秒杀会成为性能瓶颈,多启动一个服务器
- 缓存双写一致性问题 canal
- Randomxfile随机访问文件,多线程异步并发写 断点续传
- 遇到过哪些bug:
- Integer不能用==判读
- 给前端传19位长度的outTradeNo雪花算法
- @Transactional失效
- SQL列名和关键字重名,必须用${}
- 看过哪些相关书籍: